Para un robot, la coreografía es un problema de planificación
Una coreografía se puede escribir en una línea: tinku 10, kullawada 10, breaking 10. Para un robot esa línea es un problema de planificación: una secuencia de movimientos, en el espacio y en el tiempo, que un cuerpo de 29 motores pueda sostener. Esta nota cuenta cómo Paqarina convierte la línea en movimiento, y las formas que toma la misma danza en el camino: imagen, puntos, palabras, sonido y ángulos de motor.
Una danza, cinco formas
Una danza del archivo es el mismo movimiento guardado en cinco formas.
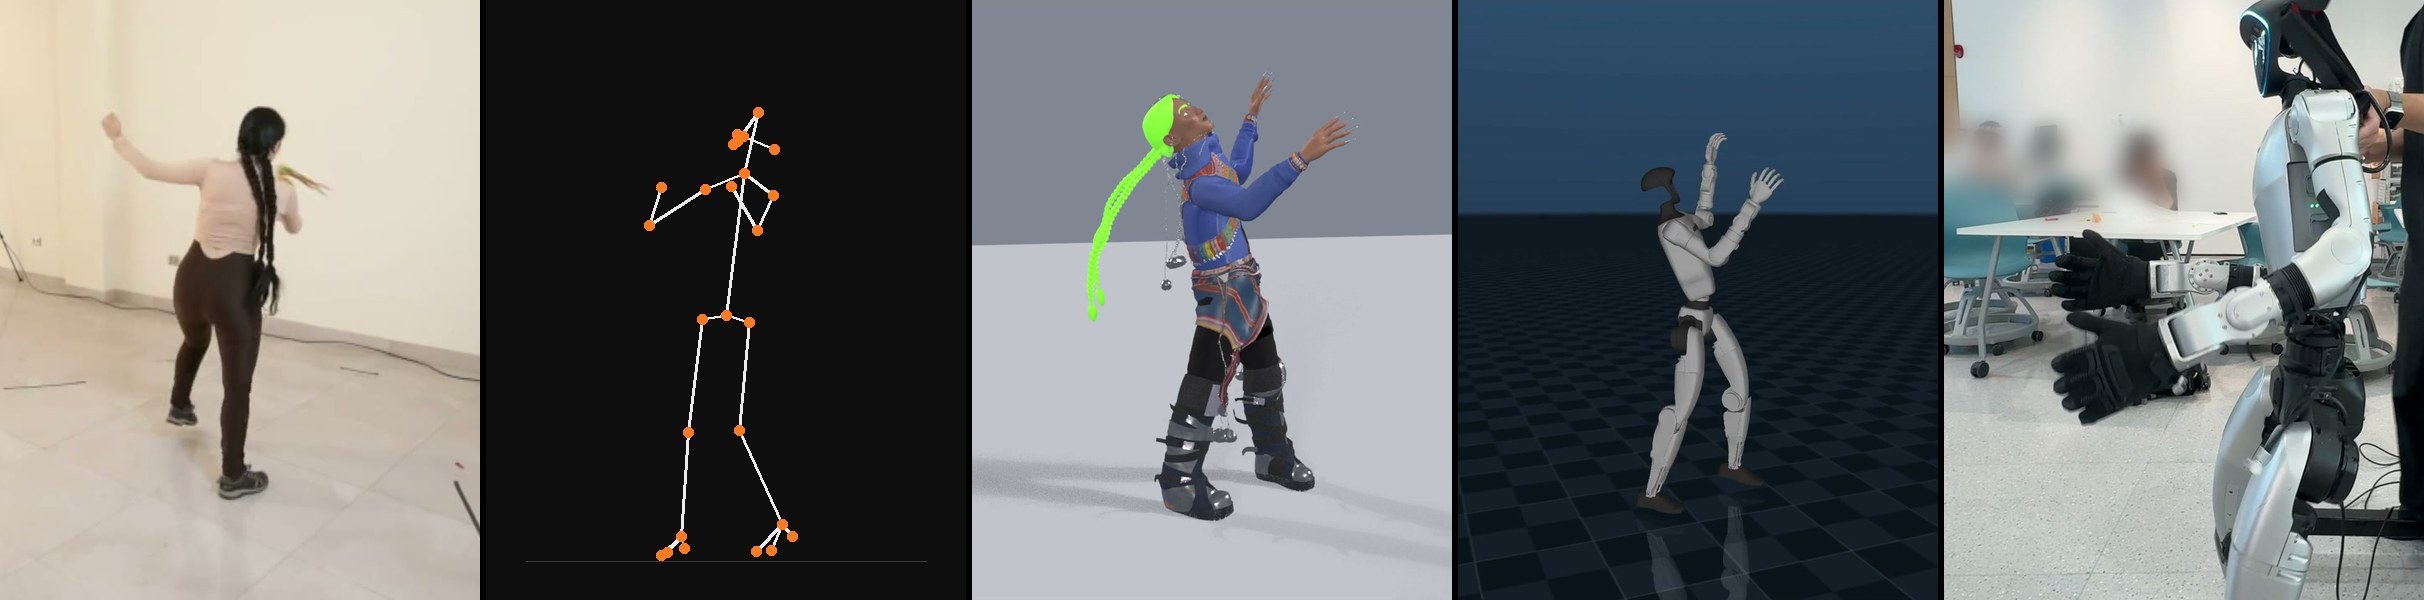
| Forma | Qué es | De dónde sale |
|---|---|---|
| Imagen | Cuatro videos de la misma toma, 24 imágenes por segundo | Cuatro cámaras alrededor de quien baila |
| Puntos | 26 puntos del cuerpo en el espacio, en cada instante | Las cuatro vistas, juntas |
| Palabras | El nombre de la danza, y la partitura: qué danza, por cuántos segundos | El catálogo y la coreógrafa |
| Sonido | La música que escucha quien baila | La sesión |
| Ángulos de motor | 29 ángulos, 50 veces por segundo | Los puntos, ajustados al cuerpo del robot |
El robot agrega una sexta forma que no nos dio ningún bailarín: lo que siente. 50 veces por segundo lee 154 números sobre su propio cuerpo y sobre la danza que está siguiendo.
A un sistema se le dice multimodal cuando trabaja con varias de estas formas y puede pasar de una a otra. En Paqarina cada paso es una pieza aparte, y no todas existen.
| De | A | Cómo está |
|---|---|---|
| Imagen | Puntos | Funciona. Todas las tomas del archivo pasaron por ahí |
| Puntos | Ángulos de motor | Funciona. Así llega cada danza al robot |
| Palabras | Una remezcla: pedazos grabados unidos en un orden nuevo | Funciona una primera versión. Es el planificador de esta nota |
| Puntos y el nombre de una danza | Danza nueva | Funciona. Escribió la suri sicuri de esta serie |
| Ángulos de motor y lo que siente el robot | Órdenes a los motores | Funciona en simulación. En el robot real, seis segundos hasta ahora |
| Sonido | Movimiento | No está hecho. El compás lo llevan los bailarines, no el modelo |
| Imagen y palabras juntas | Una razón de por qué una frase le sirve a un cuerpo | No está hecho. Hacia ahí va el trabajo |
La coreografía en términos de un robot
Una coreógrafa y una ingeniera en robótica nombran las mismas cosas con palabras distintas.
| La coreógrafa dice | La ingeniera dice | En Paqarina |
|---|---|---|
| Una frase | Un segmento de movimiento | Dos segundos de una toma grabada: 48 instantes de 26 puntos |
| Dónde está la bailarina | El estado | Dónde está la cadera en el piso, hacia dónde mira, y la postura |
| Lo que hace una frase | Una acción | El cambio de postura, el giro, el desplazamiento y el cambio de altura en el medio segundo siguiente |
| El escenario | El espacio de trabajo | Un círculo alrededor del punto de partida: 1,5 metros de radio para una bailarina, 3 metros en la app |
| Quedarse de pie | Una restricción | La cadera no baja del 85 por ciento de su altura de pie |
| La unión entre dos frases | Una transición | El pedazo siguiente empieza en una postura parecida a donde terminó el anterior, y los dos se funden en un cuarto de segundo |
| Una pareja | Un segundo agente | Una segunda bailarina que se queda entre 1,0 y 1,8 metros de la primera y la mira |
| Cómo empieza y cómo termina | El primer estado y el último | Tres segundos de quietud, en una postura en la que el robot puede estar de pie. Se pide en todas las tomas desde la próxima grabación |
| El tempo | Límites de velocidad | Cada motor tiene una velocidad máxima. La de la rodilla es 20 radianes por segundo |
De una línea a 26 segundos
Paqarina genera las danzas que aprendió de dos maneras: danza nueva, y remezclas de lo que se bailó, unidas según cómo encajan los pedazos. Esta nota trata de la segunda, pedida en palabras.
El planificador empieza con un modelo chico de cómo cambia un cuerpo que baila. Aprendió de 238 tomas grabadas: 137 nuestras, y 101 tomas cortas de danza urbana de una colección pública.
Aprendió a dos velocidades. En la primera ve medio segundo de un cuerpo y una acción, y predice el cuerpo medio segundo después. En la segunda hace lo mismo con dos segundos. Vio 51.498 ejemplos del primer tipo y 23.311 del segundo. Entrenarlo tomó cuatro minutos en una computadora portátil.
No predice imágenes ni puntos. Predice 64 números que resumen dónde va a estar el cuerpo. En robótica a esto se le dice modelo del mundo: responde a la pregunta, si el cuerpo hace esto, dónde va a estar.
Después viene la búsqueda. La partitura dice tinku 10, kullawada 10, breaking 10, en segundos. El planificador la corta en 15 pasos de dos segundos. Prueba 512 secuencias de acciones, se queda con las mejores, y repite 40 veces. Una secuencia es buena cuando pasa por el tipo de movimiento de cada danza, se queda dentro del círculo y se queda de pie.
El último paso es lo que hace que el resultado se le pueda dar a un robot. El planificador no inventa movimiento. Para cada paso de dos segundos toma el pedazo grabado más parecido a lo que pide el plan. El plan decide el orden, y cada instante lo bailó una persona. Es una remezcla.
La línea se volvió 26,5 segundos: 15 pedazos cortados de 8 tomas, todas de nuestras propias grabaciones. Los 15 son de la danza que pedía la partitura.
Dos límites se pasaron por poco. Pedimos que la bailarina se quedara a menos de 1,5 metros de la partida, y el resultado llegó a 1,69. Pedimos que la cadera se quedara por encima del 85 por ciento de su altura de pie, y bajó hasta el 83. El planificador trata sus límites como costos, no como paredes. Para un robot, algunos van a tener que ser paredes.
Dos cuerpos en un plan
Un plan puede tener dos bailarinas. La segunda se planifica alrededor de la primera: dónde empieza, a qué distancia se queda, y que mire a su pareja.
En el primer dúo planificado la segunda bailarina empezó a 1,5 metros al costado. Pedimos una distancia entre 1,0 y 1,8 metros. El plan la mantuvo entre 1,10 y 1,89.
Una versión anterior, de septiembre, unía pedazos por parecido en un orden que le dimos: breaking, tinku, suri sicuri, breaking, kullawada. Pedimos más de un metro entre las dos, y lo más cerca que estuvieron fue 1,08 metros. El piso se permitió para el breaking y para nada más, así que la primera bailarina baja entre los segundos 1,9 y 3,6 y en ningún otro momento.
El escenario en la app
La coreógrafa tiene su propia entrada al plan. En la app el piso es un escenario, con un círculo de 3 metros. Cada bailarín tiene una marca en el piso que dice dónde empieza y hacia dónde mira. La pieza se divide en bloques con una duración en segundos, y cada bailarín recibe una toma para cada bloque.
En términos de un robot esto es un plan para varios agentes, escrito a mano: quién, dónde, mirando a qué, por cuánto tiempo.
Lo que le pedimos al robot
Cuatro de las ocho danzas que practicó son remezclas, unidas con pedazos de danzas distintas según cómo encajan. Medidas:
| Lo que se pide | Tinku, después kullawada | Kullawada, después toprock | Tinku, después toprock | Tinku, kullawada, toprock |
|---|---|---|---|---|
| Duración | 32 s | 32 s | 32 s | 31 s |
| Pedazos | 2 de 15 s | 2 de 15 s | 2 de 15 s | 3 de 10 s |
| Ángulos de motor mandados | 45.965 | 45.965 | 45.965 | 45.588 |
| Lo más lejos de donde empieza | 148 cm | 64 cm | 90 cm | 122 cm |
| Giro de la cadera, sumado | 2.128 grados | 2.123 grados | 2.135 grados | 2.449 grados |
| El pie más alto | 60 cm | 57 cm | 68 cm | 55 cm |
| La rodilla más doblada | 134 grados | 141 grados | 152 grados | 128 grados |
| La mano más alta | 144 cm | 139 cm | 142 cm | 161 cm |
La línea planificada de esta nota el robot no la ha practicado. Ajustada al cuerpo del robot, esto es lo que pediría:
| Lo que se pide | Valor |
|---|---|
| Duración | 26,5 s |
| Pedazos | 15 de 2 s |
| Distancia entre el cuerpo del robot y los puntos de los bailarines | 2,7 cm |
| El tobillo derecho contra su límite de 15 grados hacia el costado | 24 por ciento del tiempo |
| El tobillo izquierdo contra el mismo límite | 20 por ciento del tiempo |
| La rodilla más rápida | 17,9 radianes por segundo, de un máximo de 20 |
| Con arnés, en simulación | Se sostiene de pie toda la secuencia, a 2,8 grados del plan en cada articulación |
El hallazgo es el tobillo. Una bailarina apoya el canto del pie sin pensarlo. El tobillo del robot se inclina 15 grados a cada lado y nada más, y este plan le pide ese límite la quinta parte del tiempo. El planificador no lo sabía. Conoce el escenario y la altura de la cadera, y todavía nada de las articulaciones del robot.
Hacia dónde va
Hoy las formas se unen de a dos. El paso que no hemos dado es un modelo que mire el video y lea la partitura a la vez, y guarde una imagen del cuerpo en el espacio. No solo reconocería un movimiento. Razonaría cómo cada movimiento cambia el cuerpo, y buscaría una secuencia que sea buena danza y además posible: dentro del escenario, de pie, dentro de los motores, al lado de una pareja.
Eso es lo que quiere decir un robot multimodal en este trabajo: uno para el que una partitura en palabras, una bailarina en video, la música y su propio cuerpo son la misma danza.
La próxima grabación está hecha para eso. Los mismos bailarines bailan tinku, suri sicuri y kullawada con un solo popurrí de tres minutos. Hay dúos entre suri y breaking. El piso lleva las marcas de un escenario, y cada toma empieza y termina con tres segundos de quietud.
Gracias
Paqarina es un proyecto de la Mozilla Fellowship.
Gracias al Dr. Pan Hui, a la profesora Xin Tong y a Jie Yu por permitirnos probar nuestras políticas en el robot.
Lo que muestra el registro
| Medida | Valor |
|---|---|
| Formas en que se guarda la misma danza | 5, y una sexta que agrega el robot |
| Tomas grabadas de las que aprendió el modelo del planificador | 238: 137 nuestras y 101 de una colección pública |
| Ejemplos de medio segundo | 51.498 |
| Ejemplos de dos segundos | 23.311 |
| Tiempo para entrenar el modelo del planificador | 4 minutos, en una portátil |
| Secuencias probadas en cada ronda de la búsqueda | 512, durante 40 rondas |
| La partitura | tinku 10, kullawada 10, breaking 10 |
| El resultado | 26,5 s, 15 pedazos de 8 tomas |
| Pedazos de la danza que pedía la partitura | 15 de 15 |
| Radio del escenario, pedido y alcanzado | 1,5 m y 1,69 m |
| Altura de la cadera, pedida y alcanzada | 85 y 83 por ciento de la altura de pie |
| Distancia en el dúo planificado, pedida y mantenida | de 1,0 a 1,8 m, y de 1,10 a 1,89 m |
| El tobillo derecho del robot en su límite de costado, en la línea planificada | 24 por ciento del tiempo |
| Remezclas entre las danzas que practicó el robot | 4 de 8 |
| Líneas planificadas que practicó el robot | 0 |
Lo que queda abierto
Si el planificador puede leer los límites del robot como lee el escenario: los 15 grados del tobillo, la velocidad de cada motor, el equilibrio. Si el sonido puede guiar, para que un plan caiga en el compás del popurrí. Si un dúo entre un robot y una persona se puede planificar con la distancia como pared y no como costo. Si un solo modelo puede tener juntas la imagen, las palabras y el cuerpo, y decir por qué funciona una frase. La primera línea planificada le pidió al tobillo del robot su límite la quinta parte del tiempo. Los próximos planes leen las articulaciones del robot antes de elegir.